新しいAI(主にはバージョンアップやグレードアップ)が出てくるたびに、
「あ~あ、きっといつまでもこの覇権競争は続くんだろうなぁ」と思うばかりです。
学生向けに「AIとはなんぞや」のセミナー外部講師としてやっていると、
毎度のごとく「どのAIを選んだらいいのかわかりません」と尋ねてきます。
答えは決まってて、「どれでも好きなの選べば。」と突っ返しています😑
その理由は、AIの覇権競争とはAIの上書き競争に他ならず、今日はこれが良さそう!
と思っても翌日には違うAIをお勧めしたい、という繰り返しだからです。
だから、
「AIを都度追いかけるより、そのことによって何が起きてるか気が付くことの方がはるかに重要」
と学生相手に偉そうに毎度ぶっています。
その何が起きているかを知る、という観点で注目すべきニュースを見つけました。
この記事ではその話をします。
いわゆる「AIのベンチマーク」に関係した話ですが、そこで終わらないので記事にしました。
そもそもベンチマークなんぞにとんと興味はないのですが、自動運転AIの開発競争の中でも、
そのあたりの状況を押さえていないと相手にされないため、一応は知っておく必要がたまにある、
というしょうもない理由からです。
さて2026年9月、OpenAIが発表したGPT-6 Astraについて、いくつもの驚くような数字が並んでいたのです。
そこで特別に気になったのが「99.9%」という数字でした。
これは、AIの性能を測る「ARC-AGI-3」というベンチマークでGPT-6 Astraが記録したスコアです。
OpenAIはAstraについて、コンピューター操作、ブラウジング、ソフトウェアエンジニアリング、科学、専門業務などで大きく性能を伸ばしたと説明していますが、ARC-AGI-3で99.9%を記録したと発表しています。
少し前のGPT-5.6 Solは、同じARC-AGI-3で7.8%でした。
7.8%から99.9%
数字だけを見ると、「ほぼ何でもできるAIになったのか!」と思ってしまいそうです。
もちろん、そんな意味ではありません。
むしろ私が興味を持ったのは、99.9%という数字そのものよりも、
このベンチマークがAIに何をさせているのかでした。
そこを見ると、GPT-6 Astraが、それまでの生成AIからどの方向へ進もうとしているのかが見えてきます。
この記事では、そこのところを探ってみました。
ルールすら教えてくれない「ARC-AGI-3」
普通の試験なら、問題文があります。
「次の問いに答えなさい」「この計算をしなさい」「このプログラムを完成させなさい」と、
少なくとも何を求められているのかは分かります。
ARC-AGI-3は、そこから違います。
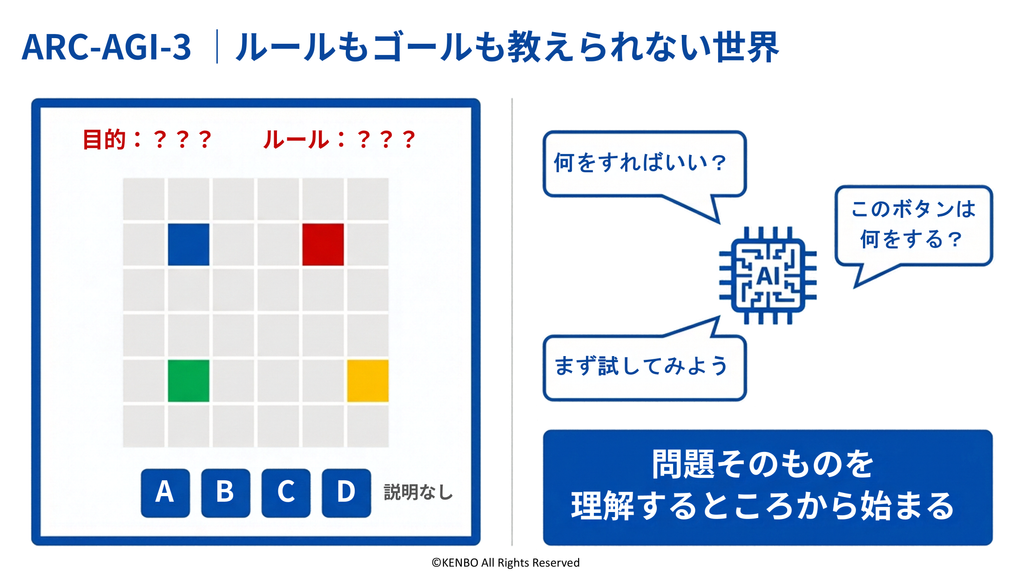
AIの前に表示されるのは、色のついたマスや図形と、いくつかの操作手段です。
しかし、遊び方も目的も教えてもらえません。
どの操作をすると何が起きるのか。
何をすれば次のステージへ進めるのか。
最初は、それさえ分からない状態から始まります。
ARC Prize(下記注)はARC-AGI-3を、説明のない新しい環境の中でAIが探索し、適応し、行動できるかを見る「interactive reasoning benchmark」と位置づけています。
ARC Prizeと99.9%についての補足
ARC Prizeは、正確にはARC Prize Foundationという非営利団体が運営する、AGI(汎用人工知能)の研究を促進するための取り組みです。
AIが「覚えた知識を答える」だけでなく、人間のように未知の課題を効率よく学べるかを測るARC-AGIシリーズのベンチマークを開発しています。
加えて、そのベンチマークを使った賞金付きのオープンな競技も実施しています。
なお、ARC Prizeによれば、99.9%はAstraの推論状態を保持し、長い作業を圧縮しながら継続できるProvider Adapter環境での最高値です。標準的な共通環境では62.7%でした。この差そのものが、モデル単体だけでなく「記憶や実行環境を含む仕組み」が重要になっていることを示しています。
ARC-AGI-3~ルールもゴールも教えてくれないベンチマーク
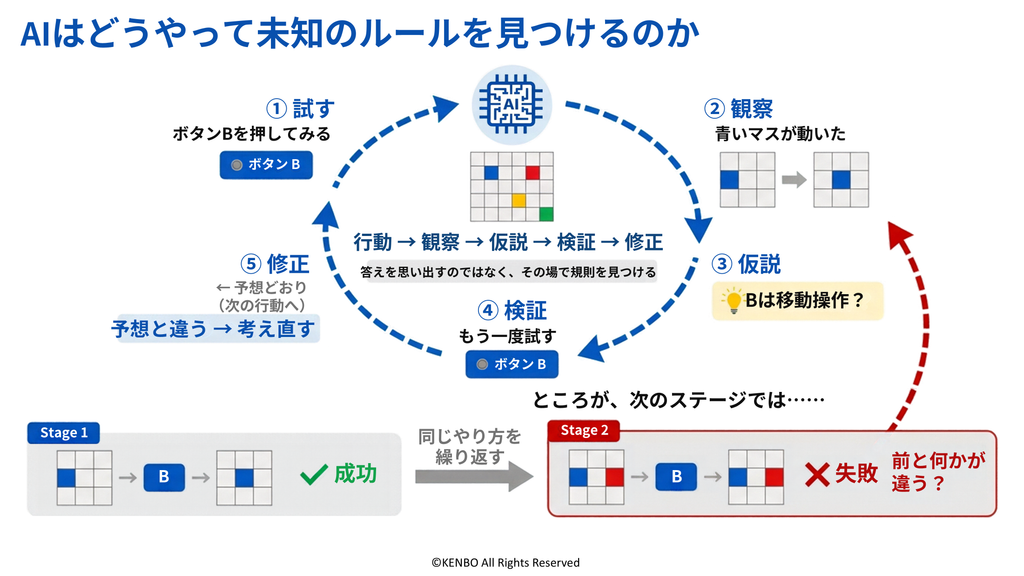
AIは、まずボタンを押してみます。
すると、青いマスが動いたり、色が変わったり、何か新しいものが現れたりします。
そこで初めて、
「このボタンを押すと、右へ動くのではないか」
と仮説を立てられます。
もう一度試してみる。
予想どおりなら、その考えを次の行動に使います。
予想と違えば、考え直します。
つまりAIは、最初から答えを知っているわけではありません。
行動して、結果を見て、そこから世界の仕組みを推測している。
ここが重要なポイントです。
ARC-AGI-3では、探索、環境のモデル化、目標設定、計画と実行といった能力が問われます。
単に正解へたどり着けばよいのではなく、環境から必要な情報を得ながら、行動を変えていかなければなりません。
さらに厄介なのは、一度うまくいった方法が、そのまま次でも通用するとは限らないことです。
ステージが変われば、新しい仕組みが加わります。
さっきまで「これで正解だった」のに、同じことをすると今度は失敗する。
そこでAIは、
「前と何が変わったのだろう?」
と、もう一度考えなければなりません。
行動 → 観察 → 仮説 → 検証 → 修正
考えてみれば、人間は似たことを日常的にやっています。
新しいスマホを買ったとき、取説を最初から最後まで読んでから触る人はあまり多くないでしょう。
私も取説を開いたことありません。
画面を触ってみて、メニューを開いてみる。違ったら戻る。
そうしているうちに、「この操作をすると、こうなるらしい」と分かってきます。
初めて訪れた駅でも同じです。
すべてを知っているわけではなくても、案内表示や人の流れを見ながら、
「こっちがホームだろう」と判断できます。
これまでのAIが苦手としてきたのは、まさにこうした
「知らない世界に入ってから、その場で仕組みを理解すること」
でした。
じゃぁ、人間は得意かというと決してそういうことではありません。
例えばもし再就職で、新しい職場に入ることになったら・・・ドキドキだけではない緊張があるはずです。
「この知らない世界で自分はどう振舞うべきか?」
「職場の人と仲良くなりたいがどうしたらいい?」
なにしろ人間相手となると、途端にモノゴトはややこしくなりがちです。
ただ、その知らない世界で、自分はどういう立ち位置にいるのか、周りはどんなふうに働いているのか、
そういったことはまさに「その場で仕組みを理解する」行為です。
人間なら、そういう場にいきなり放り込まれても試行錯誤しながら頑張るでしょう。
AIが苦手とする、というのはこういう動き方がなかなかできなかった、という意味です。
なぜ、数あるベンチマークの中でARC-AGI-3なのか
ここで一度、「ベンチマーク」という言葉そのものを整理しておきたいと思います。
ChatGPTやGemini、Claudeを毎日欠かさず使っている人でも、
AIのベンチマークまで普段から追いかけている人はそれほど多くないでしょう。
ベンチマークとは簡単に言えば、AIの能力を同じ条件で比較するための試験です。
ただし、「AIの賢さ」を一つの試験だけで測ることはできません。
例えばMMLUは、数学、歴史、コンピューター科学、法律など57分野にまたがる問題を使い、幅広い知識と問題解決能力を測ります。
GPQAはさらに難しく、物理・化学・生物などを中心に、専門家が作った大学院レベルの問題を扱います。
HumanEvalは少し性格が違います。文章で与えられた仕様から、実際に動くプログラムを書けるかを見るベンチマークです。
SWE-benchになると、実際のGitHub上のソフトウェア問題をもとに、AIが現実のソフトウェア修正を行えるかを評価します。
こうして見ると、ベンチマークによって測っているものがかなり違います。
MMLUなら「幅広い知識を持っているか」をみる、
GPQAなら「難しい専門問題を推論できるか」をみる、
HumanEvalなら「プログラムを書けるか」をみる、
SWE-benchなら「現実のソフトウェア問題を修正できるか」をみる。
こんな感じです。
その中で、今回ARC-AGI-3をわざわざ取り上げる理由があります。
それは、ARC-AGI-3が
「何をする問題なのか」さえ最初から与えてくれないから
です。
ARC Prize自身も、ARC-AGI-3をシリーズ初の完全なインタラクティブ型ベンチマークと説明しています。
AIは未知の環境を自分で探索し、どういう世界なのかを理解し、何を目指せばいいのかを発見しながら進みます。
だから私は、このベンチマークがAstraの変化を見るうえで面白いと思いました。
これは「AIがどれほど多くの知識を覚えたか」を競う試験ではありません。
知らないことに出会ったとき、どうするのか。
そこを見ているからです。
GPT-6 Astraは、これまでのAIと何が違うのか
ここまで来ると、99.9%という数字の見え方も少し変わってきます。
もちろん、この数字を「GPT-6 Astraなら現実の仕事を99.9%正しくできる」と解釈してはいけません。
ARC-AGI-3という特定の環境での結果です。
さらに、AIのベンチマークはモデル本体だけで決まるとは限りません。
OpenAI自身、GPT-5.6 SolをARC-AGI-3で評価した際、途中の推論を保持する設定と、長くなった情報を整理するコンパクションを有効にしたところ、公開タスクでのスコアが大きく改善したと報告しています。
これは非常に興味深い話です。
AIの「頭脳」だけを比べればよいのではなくなってきたからです。
☑️途中まで何を考えたのか。
☑️何を試して失敗したのか。
☑️今どこまで分かったのか。
そうした情報を保持できれば、AIは同じ失敗を何度も繰り返さず、前の経験を次の判断へつなげられます。
私たち人間が複雑な仕事をするとき、すべてを頭の中だけで処理しているわけではありません。
例えばメモを取り、資料を確認し、途中まで作ったファイルを見直しながら進めます。
AIも同じ方向へ進んできた、と考えると分かりやすいでしょう。
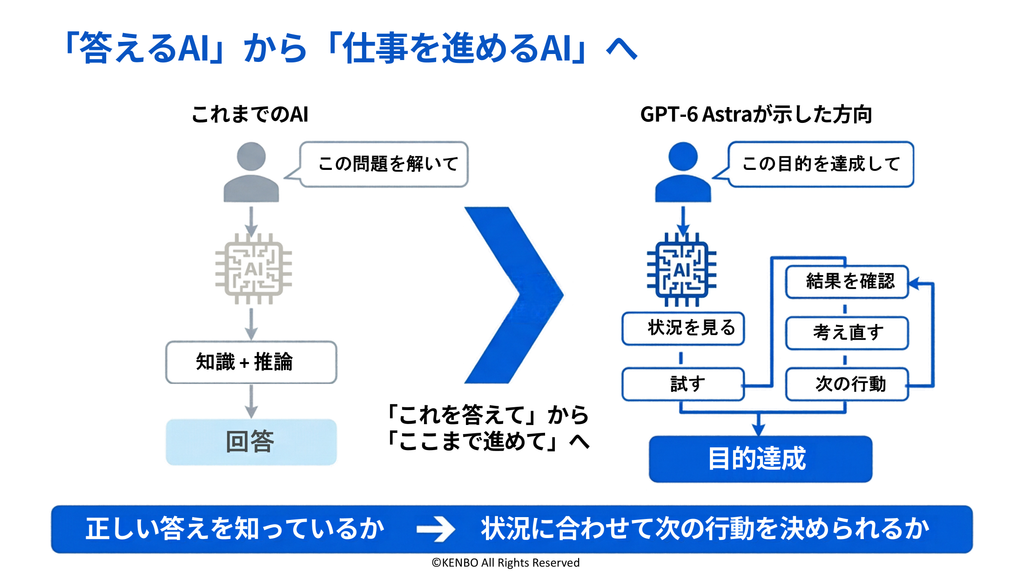
これまでの生成AIは、「この意味はなに?」「この文章を要約して」「旅行プランを考えて」「このコードの間違いを教えて」等々の質問に、普通に答えを返してくれる道具という印象が強かったと思います。
つまり、
質問 → 推論 → 回答
です。
Astraが見せているのは、その先です。
まず状況を見る。
→ 分からなければ試す。
→ 結果が予想と違えば考え直す。
→ 必要なら別の方法を使い、目的まで進む。
というふうに、人と似たような試行錯誤をしつつゴールに向かう性質です。
「答えるAI」から「仕事を進めるAI」へ
ここで起きている変化を私は、
「正しい答えを出せるか」から、
「状況に応じて次の行動を決められるか」への変化
と捉えています。
OpenAIもGPT-6 Astraについて、複雑な問題を理解する能力とコンピューター操作を組み合わせ、複数の工程にまたがる業務を進め、文書、スプレッドシート、プレゼンテーションなどの完成物を作れることを大きな特徴として挙げています。
単に「文章がうまくなった」という進歩とは、まるで意味が違います。
では、それはAIエージェントと何が違うのか
ここまでの話から想像すると、
「それってAIエージェントじゃないの?」
と思うかもしれません。
ここを少し整理する必要がありますね。
GPT-6 AstraとAIエージェントは、同じものではありません。
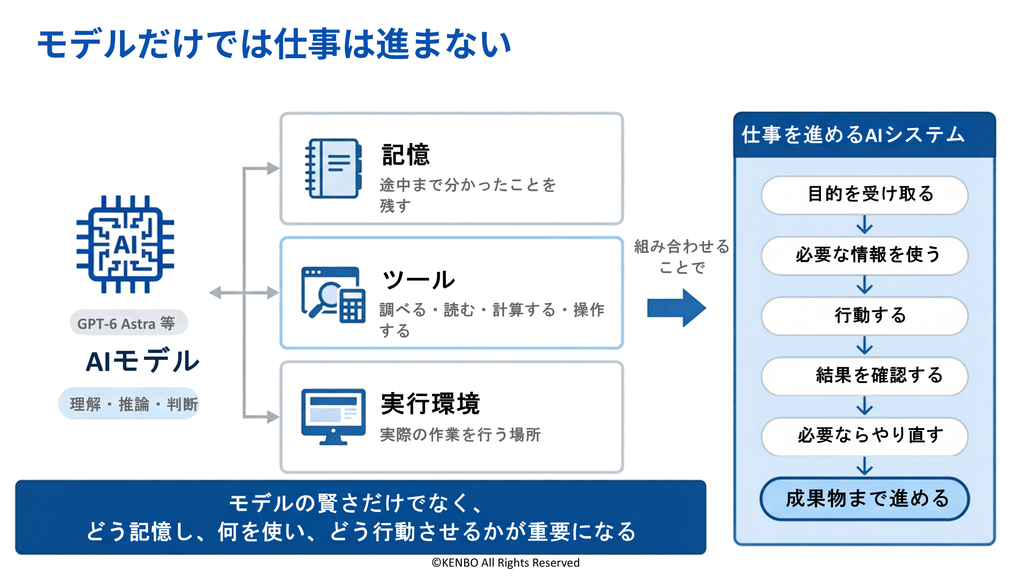
分かりやすく言えば、Astraは考える能力を持ったモデルです。
一方、AIエージェントは、そのモデルにブラウザ、ファイル操作、記憶、アプリ操作などの手段を持たせ、ある目的へ向かって仕事を進められるようにした仕組みです。
車に例えるなら、Astraはエンジンや制御系に近く、エージェントはそれを載せた車全体に近い、
と考えるとよいかもしれません。
実際、OpenAIが2026年9月29日に発表した自律型エージェント「Dots」もGPT-6 Astraを基盤モデルとして利用しています。DotsはSlackやTeamsなど複数のアプリをまたいで、ユーザーの目標に沿って継続的に作業を進める仕組みとして発表されました。
つまり、
GPT-6 AstraそのものがAIエージェントなのではありません。
Astraのようなモデルが、未知の状況を理解し、計画を修正しながら進める能力を高めているからこそ、その上に構築されるAIエージェントも、より複雑な仕事を任せられるようになっていきます。
モデル+記憶+ツール+実行環境=仕事を進めるAIシステム
この違いを理解すると、今後のAIを見る目も少し変わってくるように思います。
これまでは新しいAIが登場すると、
「どちらのモデルのほうが賢いのか」
という比較が中心でした。
もちろん、それも重要です。
しかし今後は、それだけでは十分ではなくなります。
AIにどの情報を渡すのか。途中の作業をどう残すのか。どんな道具を使わせるのか。
どこまでAIに任せ、どこで人間が確認するのか。
モデルの能力と、その周囲にある仕組みを切り離せなくなってきます。
「どの情報を読ませるのか、何を記録させるのか、どの道具を使わせるのか、どこで人間が確認するのかが重要になる」と思われます。
今回ARC-AGI-3の99.9%を調べていて、私が一番興味を持ったのも、実はそこでした。
AIが人間になったわけではありません。
まして、何を任せても正しい判断をする存在になったわけでもありません。
現実の仕事には、ARC-AGI-3のように明確なクリア条件がないものもあります。
組織で仕事をする職場を例にするとシンプルにわかりやすい。
私の関わっている職場でも、結構あやふやなままプロジェクトが進行していきます。
✔️会社(組織)の利益と安全をどう両立するのか
✔️誰にどこまで責任を持たせるのか
✔️失敗したら最後は誰がケツを拭くのか
そこには経験や価値観、人間の責任が入ってきます。
それでも、AIの役割は明らかに変わり始めています。
以前なら、人間がAIに一つ質問し、答えを受け取り、それを材料にして次の質問を考えていました。
これからは、
「これを答えて」ではなく、「ここまでやってほしい」
と仕事を渡す場面が増えていくでしょう。
GPT-6 Astraの99.9%は、AIが万能になったことを示す数字ではありません。
私にはむしろ、AIを「何を知っているか」だけで評価する時代が終わり始めたことを示す数字
のように見えます。
答えを返すだけだったAIが、状況を見て、試して、間違えれば修正しながら、目的へ近づいていく。
その変化が本格化するとき、私たちがAIに求めるものも、
「いい回答」から「いい仕事」へ変わっていくのかもしれません。
「いい仕事」をさせる取り組み例が「MIRA」
このたびリリースした【MIRA】(My Intelligent Role Agent)のちょっとした宣伝です😊
この記事で述べたような方向でAIが進化しているのを、日々ベンチマーク情報を拾い集めている仕事をしているとヒシヒシと感じています。
AIにいい仕事をさせる一環として、「AIから降りる」ことで実現する試みがMIRAとなります。
ひとつ前の記事(MIRA│AIエージェントを使わずに、生成AIへ「仕事の進め方」を持たせるMIRA)でも、
この考え方をご紹介しています。
さらにMIRA詳細にご興味ある方は以下を是非チェックしてみてくださいね!
⬇️⬇️⬇️
-
-
MIRA|ChatGPT・Gemini・Claudeに「仕事の進め方」を持たせるAIワークフロー
www.ifrv.net
