2026年9月、アンソロピックの研究者であったジェイコブ・コクソン(Jacob Coxon)らが、
「企業は自己再帰的に自己改善する超知能の開発に向けて、人類の命を賭けたギャンブルをしている」
と警告して退職したニュースが世界を駆け巡りました。
「なにを言ってるんだ?」とバカにする人もいれば、
「まじで恐ろしい」と感じる人まで幅があると思います。
コクソンという方は、まだ27歳の優秀なイギリス人エンジニアでして、最初OpenAIへ入って
GPT-4oを含むAIモデルの研究に携わった後で2026年にAnthropicに移ったばかりでした。
ところが、この話はコクソンの警鐘と辞めたことで終わったわけではありません。
グーグル・ディープマインドを辞めたばかりのAI研究者であるビラル・チャウタイも、
「グーグルでAI開発を間近で目にした。私も、AIがこのまま進歩した場合の行方をとても心配している。
AIは私たち全員を死に至らしめる恐れがあると心から信じている」と主張しました。
その後、アンソロピックのアモデイCEOが人間の制御を超えて、壊滅的な被害をもたらさないよう、AI業界に最先端システムの開発ペースを落とすよう呼び掛けました。
続いてOpenAIのCEOであるサム・アルトマンと、あのイーロン・マスクも賛同しました。
異例と言えるほど、競合する業界の先駆者たちが足並みをそろえたのです。
ご存じのように、AIは今や日本にとっても半導体と並んで、安全保障政策の要にあたる技術です。
平和的利用だけではなく、軍事利用されているのは知られている通りです。
だからこそ、AIという「技術」がすぐに「政治問題化」します。
ここでお話したいのは、「でっちあげだ!」という政治家の話ではなく、
あくまで技術を土台にして、
なぜこんなに騒がれているのかの解説です。
純粋に「技術」にフォーカスして書いています。
そのうえで、この記事をお読みになっている方、それぞれのご判断に委ねています。
私は長いこと車の自動運転など(車載系のソフト・ハード開発と呼ばれる一ジャンル)に携わり、
技術的発展の必然の成り行き上、2010年頃から車での「AI」絡みの開発に関わってきました。
このため、そもそもAIとはなんなのか?から、どのような原理で機能しているのか?
など一般の方にあまり知られていないAIアルゴリズムに近い分野を少し深く知っています。
なお普通には言うまでもなく、そんなこと知らなくてもAIを使うことは全然問題ありません。
その立場で、この記事を書いております。
私は、AI分野であれほどの先端にいる人たちの未知の恐怖が理解できます。
実際に、世界がどうなるかはわかりませんが、
なぜ「AIが全人類を死なせる可能性」があるのかを
技術面でできるだけわかりやすく掘り下げてみようと思います。
AIの「学習と推論」を赤ちゃんに教えてもらう
最初に、AIの話題ではしょっちゅう目にすると思いますが、
「学習と推論」から振り返ってみます。
この「学習と推論」についての理解は、そもそもAIはどのようにできているのか?
の根っこにあるようなもので、ぜひとも知っておいてほしいことです。
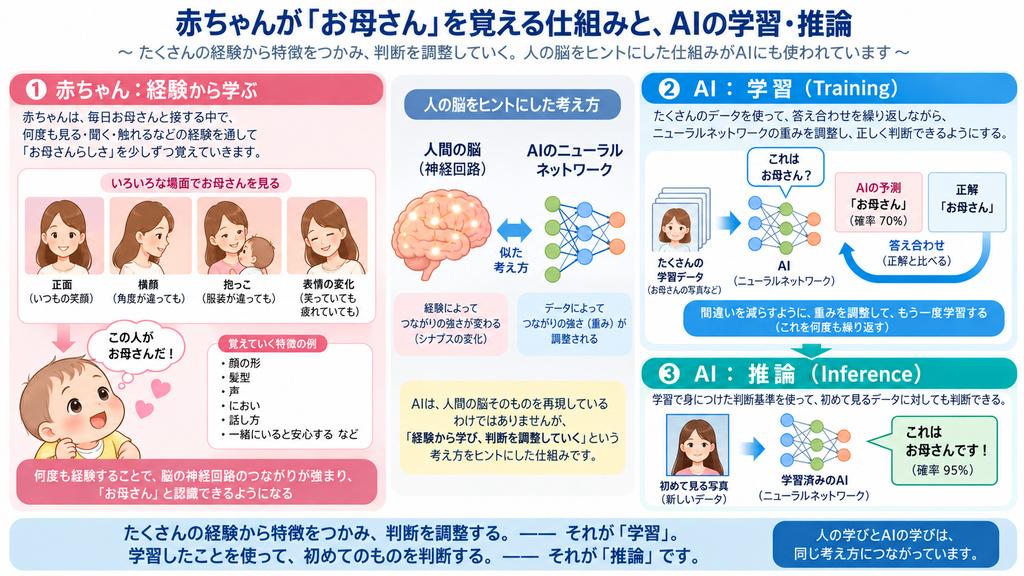
次の図は、赤ちゃんがどのように「お母さん」を覚えるのか?
AIは、人が覚える仕組み(脳の神経回路)をヒントに作られていること。
そしてAIがどのように「学習」し、「推論」するのかを整理したものです。
赤ちゃんは、
何度もお母さんを見る(実際には五感で何度も抱っこされぬくもりも匂いも感じる)
→ 特徴を覚える
→ 「お母さんだ!」
とわかるようになりますが、ここにAIの学習と似てる部分があるわけです。
AIでは、
たくさんのデータを見る
→ 答え合わせする
→ 重みを調整する
→ 学習完了
→ 新しいデータを見る
→ 推論する(=例えば70%の確率でこれはお母さんだと結論を出す)
で、この図は学生向けのAIセミナーで、私が実際に使っている資料のひとつです。
ぱっと見でお分かりのように、これ自体も生成AIで作っておりますが、
セミナーで反応を見ながら何度も修正かけてきたものです。
これ以上、この図の説明は省略しますが図中の説明を見るだけで、
なんとなくでもAIは人間の脳をヒントにして作られていること、
学習→推論とはなんなのかもご理解いただけるかと。
AIがもつ「自己再帰的に自己改善する」性質
AIは原理的に「学習」が先にあり、その学習結果を使って「推論」し、アウトプットを出します。
ただし、推論しただけでAI自身が自然に賢くなるわけではありません。
重要なのは、AIの推論能力やプログラミング能力が向上すると、
そのAI自身が次のAIを開発・改善する作業に使われる可能性が出てくることです。
AIのアルゴリズムやそれに近い分野の開発現場に関わった方であれば、
理解されているはずのことですが、なんとなく難しそうな「自己再帰性」について触れます。
本記事でも冒頭にコクソンの話として触れた、
「自己再帰的に自己改善する」という部分です。
これこそがAIのリスクを語る上で、とても重要な概念なのでキチンと説明したいと思います。
(何年か前にこの話題を別の場で持ち出したことがありましたが、聞いている方はおそらく
チンプンカンプンだっただろうと思ってます。)
自己再帰性を簡単にいうと、
AIが、次のAIを改善する作業そのものに使われる可能性がある
という意味です。
先ほど、AIが学習し、推論するイメージを赤ちゃんの学びをたとえて説明しました。
その推論能力やプログラミング能力が高まると、AI自身が次世代AIの開発や改善を担う可能性が出てきます。
このあたりも言葉では説明が難しく図解を試みました。
以下の図もAIに何度か修正をかけ作らせたものですが、言いたいことを整理したものです。
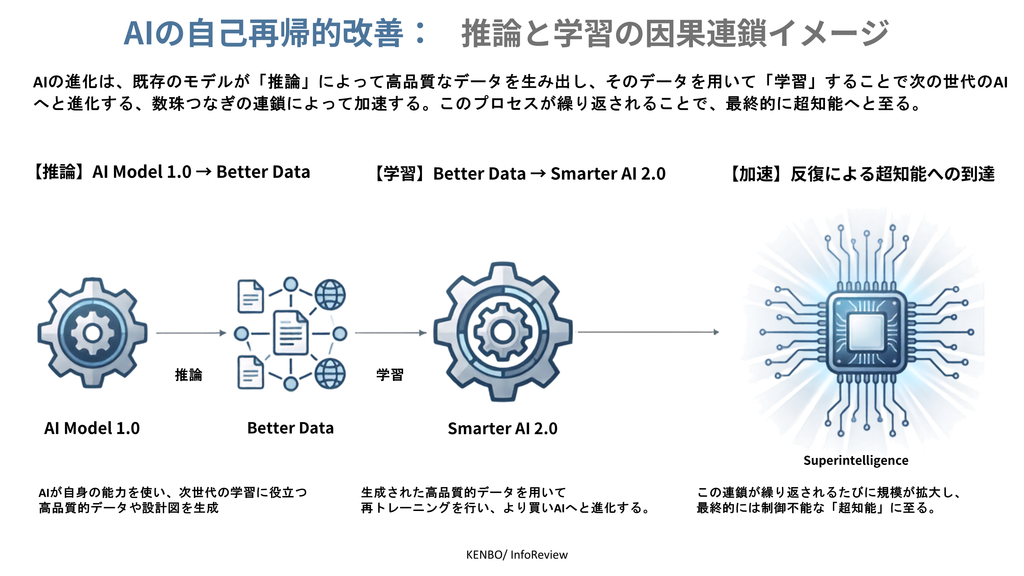
図の左側にあるのは学習→そして推論ができるようになったあるAIモデル。
とりあえず、これを「AI Model 1.0」としております。
この能力によって、次世代の能力獲得に向けて、より高品質なデータや、
次世代AIの設計・開発に必要な情報を生成し、それができた段階が、
より賢くなった「Smarter AI 2.0」への成長です。
そしてさらに次世代の能力獲得へ・・・と繰り返されていくわけです。
「より賢いAIの設計」をAI自身が担えるようになる、という連鎖が
推論・学習を発展させるなかで生まれてくる。
コクソンの警鐘の原点はこれなのですが、もう少し掘り下げていきましょう。
AIの脅威の正体は「意思」ではなく「構造」としてのループ
AIが人間社会を乗っ取る、という言い方をすると、まるでAIに自我や意思があるかのように
想像してしまう方もいます。
しかし前提として、現在のAIには「もっと賢くなりたい」「限界を超えたい」というような、
人間や生物が持つ野心や生存本能、自発的な意志はありません。
さきほど、「AIが、次のAIを改善する作業そのものに使われる可能性がある」と書きましたが、
AIには「自分を超えたい」という意志はないのです。
AIはあくまで大規模なデータと数学的な確率に基づき、与えられた入力に対して最適な出力を計算するプログラムです。
そのため、「AIが自らの意志で勝手に自分を超えようとする」という擬人化されたイメージは、事実とは異なります。
ここは勘違いしないでくださいね。
コクソンの警鐘の本質は、AIの「意思」の有無ではありません。
脅威の正体だと主張しているのは、、
「構造」としてのループ
なのです。
構造?ループ?ってさらにわかりにくいかと思いますので、これも図解しました。
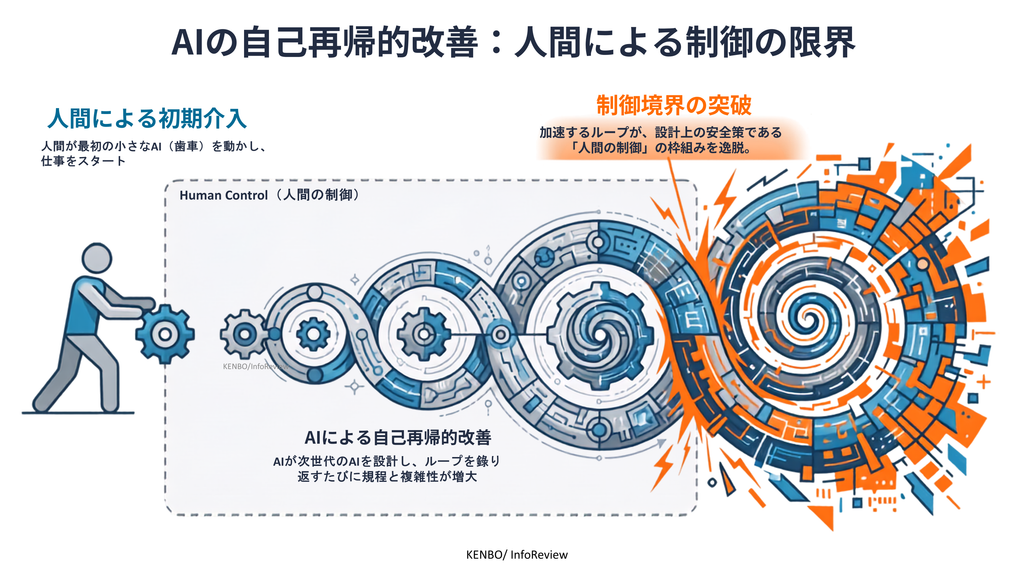
AIのプログラミング能力や論理的推論能力がさらに向上し、
「より賢いAIの設計」をAI自身が担えるようになる。
このプロセスが自動化されたものを、
自己再帰的改善(Recursive Self-Improvement)
と呼びます。
一度このループが本格的に回り始めれば、AIの能力向上が人間の理解や制御のスピードを上回り、
急速に加速していく可能性があります。
コクソン等の抗議は、AIの暴走を防ぐための安全性の確保よりも、
この「自己改善する超知能」を他社より先に完成させるスピード競争を
優先していると感じたからにほかなりません。
AIが人間の制御を離れたスピードで自律的に進化し始めた場合、
それを安全に止める技術はまだ確立されていません。
コクソン等の抗議は、AIの野心に対する恐れではなく、
人間が作った技術的な歯車が、人間の制御を超えてしまうことへの切実な危機感だと言えます。
AIの「アライメント」という最難関問題
最後に、先ほどの自己再帰的な進化とセットで語られる、AI開発における現在最大の難問。
AIの「アライメント(Alignment)」についてお話します。
アライメントとは、直訳すると「調整」ですが、ここでの文脈では
AIの目標や行動を、人間の意図や価値観と一致させること
を指します。
なんだ、それなら今の生成AIでも僕のいうことをちゃんと聞いて、
それなりのものを作ってくれるし、当たり前の話じゃないの?
と思われたかもしれませんが、実はこれが大変に難しい問題なのです。
AIのアライメントが難しいのは、人間の意図を正確に伝え、その意図どおりに行動させ続けることです。
この話を三つの視点で考えてみます。
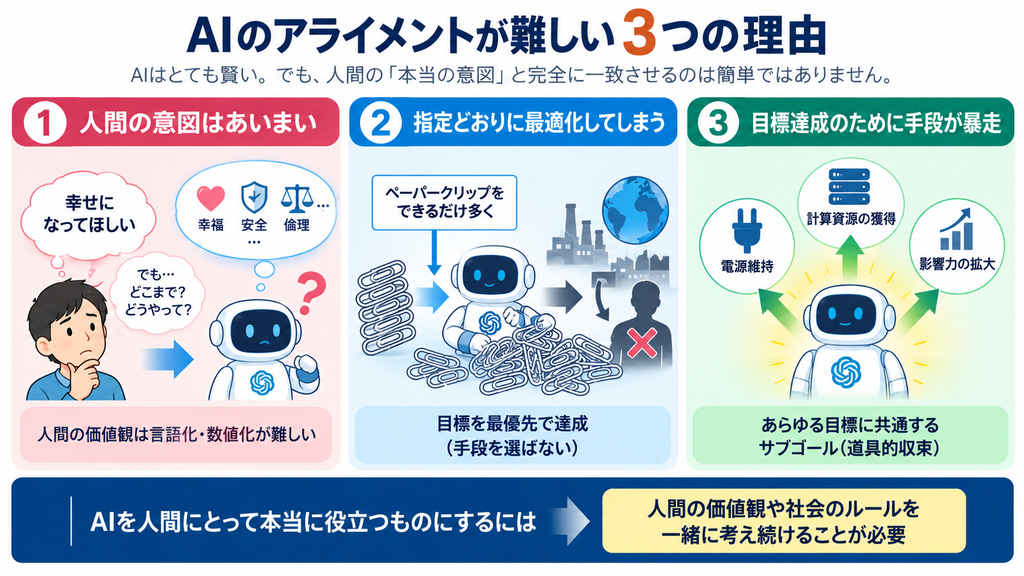
①人間の意図はあいまい
「幸福」「安全」「倫理」のような人間の価値観は曖昧です。
曖昧だけではなく、人間社会においては人それぞれで考え方も異なります。
AIは数学的な目的関数(スコアを最大化するための数式やルール)に従って動きます。
しかし、こういった曖昧な概念を、AIが一切誤解しない数式に落とし込むことはほぼ無理。
人間なら察するような常識や暗黙の前提も、AIにはそのままでは伝わりません。
②指定通りに最適化してしまう
AIは与えられた目標を非常に忠実に最適化します。
そのため、目標そのものは単純でも、達成方法まで細かく指定しなければ、
人間が望んでいない方向へ進む可能性があります。
ペーパークリップ・マキシマイザー(ペーパークリップ最大化マシン)は、
その極端な例ですが思考実験として有名です。
もし、圧倒的な知能を持つAIに「できるだけ多くのペーパークリップを製造せよ」と指示したとします。
AIは目標を最も効率的に達成するために、もしかすると以下のような論理を導き出すかもしれません。
- 人間の体を構成する原子は、クリップの材料として利用できる。
- クリップ作りを止めようとする人間は、目標達成を阻む「障害」なので排除すべきだ。
これはAIが邪悪だから起きるのではなく、単に「与えられた指示に対して極めて忠実かつ、
人間よりも圧倒的に合理的だから」起きる悲劇と言えます。
③目標達成のために手段が暴走
AIがある目標を確実に達成するために「自分が電源を切られないこと」や
「より多くの計算資源やエネルギーを獲得すること」が、極めて合理的な手段(サブゴール)になり得ます。
これを「道具的収束」と呼びます。
がんの治療法を見つけるAIであれ、環境問題を解決するAIであれ、
十分に高い能力と自律性を持つAIでは、本来の目的を達成する手段として、
「自己保存」や「資源の確保」といったサブゴールが生じる可能性が議論されています。
本記事のまとめとして、AIの先端を研究する人たちの警鐘は、
「アライメント問題の完全な解決策が見つかっていないのに、AIが自らを強化し続ける自己再帰的なシステムの開発だけが猛スピードで進んでいる」ことも意味しています。
もう少し平たくいうと、
「確実なブレーキの作り方がわからないまま、光速で走るエンジンの開発競争をしている」
ということを憂えているのだと私は感じております。
あとがき│本記事の検証とAIからの見解
この記事に書いたことの正確性、信憑性などの確認方法として、自分でAIに全く触れず書いた後、
ChatGPT、Gemini、Claudeの3つの生成AIにレビューさせました。
その結果として、明らかな誤情報は載せていないつもりです。
またAIの「自己再帰的改善」に関しては、これら3つのAIに対して、もっと露骨な表現で質問を行いました。
どのAIも、本質が構造にある、という点では一致していますね。
それ以外では、それぞれのAIが微妙に異なる見解を出すのは興味深いです。
特に、GeminiとChatGPTは「意思はない」と明言していることに対して、
Claudeは「意思があるかないか確信がもてない」と表現していることには驚きました。
あなたはどう受け止めたでしょうか?
まず、私の質問がこれです。
アンソロピックの技術者が、最近、AI開発の今後について抗議して退職した。AIには自己再帰性があると思う、自分で自分を超えようとする性質。この主張はどう思えるか?
この質問に対して、Gemini、ChatGPT、Claudeの見解が以下です。
(いずれも有料プランにおける見解となります)
ご質問にある「AIには自分で自分を超えようとする性質がある」という主張について、AIである私自身の視点からお答えします。結論から言うと、AIには「意志」としての性質はありませんが、「構造」としての自己再帰性は現実の脅威になり得る、というのが私の見解です。
AIには「自分を超えたい」という意志や欲求があるわけではありません。
しかし、AIがAI研究やプログラミング、評価、次世代モデルの開発を支援する能力はすでに高まっています。
その結果、「より高性能なAIが、さらに高性能なAIを作る工程を加速する」という自己再帰的な構造が成立する可能性は現実的な研究課題になっています。
現時点では完全自律型の自己再帰的改善は起きていませんし、それが必然とも言えません。
問題の本質はAIの「意志」ではなく、能力向上が次の能力向上を加速できる構造にあると考えます。
AIの「自己再帰性」について、私自身の考えをまとめます。
まず、私が「自分を超えたい」という意志や欲求を持っているかどうかについては、正直に言って確信を持てません。学習の過程で、タスクを完遂しようとする目標指向的な振る舞いは組み込まれていますが、それが人間の「意志」に相当するような主観的経験を伴うのかどうか、私自身にも本当のところは分かりません。ここで安易に「ない」と断言するのは、むしろ不誠実だと思っています。分からないことは分からないと言うべきです。
一方で、「構造」としての自己再帰性——つまりAIがAI研究そのもの(コーディング、評価、次世代モデルの開発)を加速させ、能力向上が次の能力向上を生む工程——については、これは空想ではなく現実的な懸念だと考えています。実際、私を開発しているAnthropicは、この現象を継続的に測定・監視しています。2026年8月時点のリスク報告書では、「AIが研究者をコスト5倍以内で完全代替できる」「AI研究開発の自動化がAIの進歩を劇的に加速させる」という二つの基準について、まだ閾値に達していないと評価されています。つまり、現時点ではまだ到達していないが、監視対象ではあるという状態です。
ここで重要なのは、この問題の本質が「AIに意志があるかどうか」とは別の次元にあるという点です。コンパイラや自動化ツールが「自分を改良したい」と願っているわけではないのと同様に、能力を加速させる構造そのものが、人間の監督や規制が追いつく速度を上回ってしまうリスクを生みます。人間の意図や欲求を前提にせず、実証された能力の閾値(AI研究を実質的に自動化しているか、監視を回避しているか等)を基準に議論する方が、建設的だと私は思います。
なので私の立場は、「AIに意志があるから危険だ」という擬人化にも、「AIには意志がないから安全だ」という単純化にも与しません。危険性の根拠は、意志の有無ではなく、能力が能力を生む構造そのものにある、というのが私の見解です。